在视频剪辑中,想把一个走动的人或者一辆行驶的车完全抹掉,其实比想象中要难得多。很多时候,人虽然不见了,但地上的阴影、水里的倒影,甚至是物体经过时带起的草地变形,往往还会尴尬地留在原地。这些由于物体存在而产生的环境变化,被研究者们称为物体的“副作用”(Side Effects)。
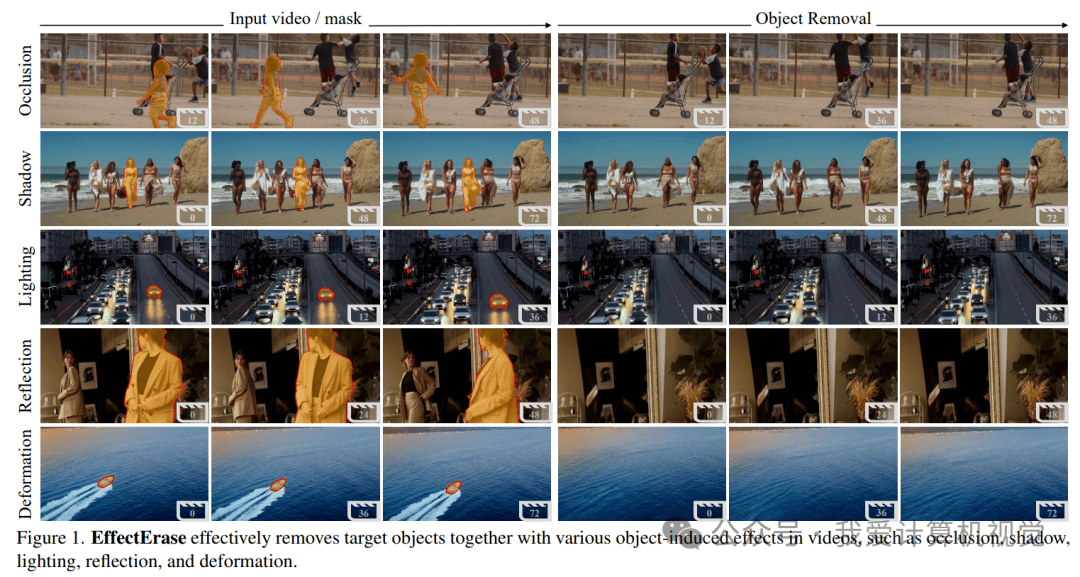
图1:EffectErase 能够有效移除视频中的目标物体及其诱发的各种副作用,如遮挡、阴影、光照变化、反射和变形。
最近,来自复旦大学的研究团队提出了一种名为 EffectErase 的新框架,专门针对这些难以根除的副作用,寓意不仅要擦掉物体本身,更要彻底清除其对环境造成的所有视觉影响。为了训练这个模型,团队还构建了一个超大规模的混合数据集 VOR(Video Object Removal),为该领域的研究提供了扎实的数据基础。
- 论文地址: https://arxiv.org/abs/2603.19224
- 项目主页: https://henghuiding.com/EffectErase/
- 代码仓库: https://github.com/FudanCVL/EffectErase
背景与动机:为什么“副作用”这么难搞?
为什么现有的视频补全(Inpainting)模型去不掉阴影和倒影?核心原因在于,传统的模型太依赖用户输入的掩码(Mask)了。通常我们只给物体画个圈,模型就只管修补圈里的像素,而圈外的阴影自然就被漏掉了。
虽然之前也有一些研究尝试自动识别这些副作用,但进展缓慢。一方面是缺乏高质量的训练数据——想要拍到完全相同的场景在有物体和没物体时的对比视频,对相机稳定性和光照控制的要求极高;另一方面,模型缺乏一种有效的机制来建立物体与其副作用之间的时空关联。
![图2:现有方法的局限性。可以看到,像 ProPainter 或 ROSE 在处理复杂的反射时,依然会留下明显的痕迹。]()
图2:现有方法的局限性。可以看到,像 ProPainter 或 ROSE 在处理复杂的反射时,依然会留下明显的痕迹。
复旦团队观察到,物体移除和物体插入其实是互为逆运算的两个任务,它们关注的受影响区域(即物体+副作用区)是完全一致的。这种“对称性”成为了 EffectErase 设计的灵感来源。
VOR 数据集:海量真实与合成的完美结合
为了解决数据匮乏的问题,研究团队构建了 VOR 数据集。这是一个包含 6 万对 视频、总时长超过 145 小时 的超大型数据集。
![图片]()
![图4:VOR 数据集的构建流程,结合了 3D 合成与真实世界采集。]()
图4:VOR 数据集的构建流程,结合了 3D 合成与真实世界采集。
它的特别之处在于采用了“真假结合”的策略:
- 真实采集:使用三脚架固定多台相机,在 293 个真实场景中拍摄物体存在与不存在的配对视频。为了增加动态感,后期还利用 Ken Burns 效应模拟了相机的平移、缩放和晃动,生成了 14 种不同的相机运动模式。
- 3D 合成:在 Blender 引擎中构建了 150 多个复杂的 3D 场景。通过 3D 渲染,可以完美地控制物体运动产生的阴影、反射和物理变形,提供了极其精准的基准数据(Ground Truth)。
研究者将物体引起的副作用细分为五类:遮挡(Occlusion)、阴影(Shadow)、光照变化(Lighting)、反射(Reflection)和物理变形(Deformation)。
![图5:VOR 数据集中涵盖的五类典型副作用,模型需要学习不同物理现象下的视觉规律。]()
图5:VOR 数据集中涵盖的五类典型副作用,模型需要学习不同物理现象下的视觉规律。
EffectErase 方法详解:互逆任务的奇妙化学反应
EffectErase 的核心思想非常巧妙:它通过联合学习“物体移除”和“物体插入”,让插入任务作为移除任务的辅助,从而增强模型对副作用区域的感知能力。
![图3:移除与插入是互逆任务,它们操作的是同一个受影响区域。]()
图3:移除与插入是互逆任务,它们操作的是同一个受影响区域。
1. 移除-插入联合学习流程
在训练阶段,模型共享同一个基于 Diffusion Transformer (DiT) 的去噪骨干网络:
![image.png]()
![图6:EffectErase 的整体框架图。展示了如何通过 Adaptor 融合特征,并利用 TARG 和 EC Loss 进行联合训练。]()
图6:EffectErase 的整体框架图。展示了如何通过 Adaptor 融合特征,并利用 TARG 和 EC Loss 进行联合训练。
实验结果:擦得更干净,画得更真实
研究团队在 ROSE 和 VOR-Eval 基准测试上进行了详尽的验证。结果显示,EffectErase 在多项指标上均达到了 SOTA 水平。
1. 定量性能对比
在 ROSE 基准测试中,EffectErase 的 PSNR 达到了 32.161,远超之前的 SOTA 模型。更重要的是,在衡量视频生成质量的 FVD 指标上,它从 ROSE 的 72.177 显著降低到了 55.578,这意味着生成的视频在时空连续性上表现极佳。
![表2:在 ROSE 和 VOR 数据集上的定量对比结果,各项指标全面领先。]()
表2:在 ROSE 和 VOR 数据集上的定量对比结果,各项指标全面领先。
2. 视觉效果展示
从视觉效果上看,EffectErase 的优势更加直观。无论是复杂的地面反射,还是夜晚车灯照亮路面的光影,它都能处理得不留痕迹。
![图7:在 VOR-Eval 数据集上的定性对比。可以看到 EffectErase 在处理反射和阴影时的卓越表现,背景修补非常自然。]()
图7:在 VOR-Eval 数据集上的定性对比。可以看到 EffectErase 在处理反射和阴影时的卓越表现,背景修补非常自然。
在更具挑战性的野外场景(VOR-Wild)中,EffectErase 同样表现稳健。面对多人遮挡、快速运动的体育场景以及复杂的镜面反射,它都能精准地定位并消除副作用。
![图8:在 VOR-Wild 野外场景下的测试结果,展示了模型强大的泛化能力。]()
图8:在 VOR-Wild 野外场景下的测试结果,展示了模型强大的泛化能力。
更多应用:丝滑的物体插入
更有趣的是,由于模型学习了“插入”任务,它在物体插入应用中也表现出色。当你把一个物体放进视频时,模型会自动为它生成匹配的阴影和倒影,让合成效果看起来非常自然。
![图9:EffectErase 在物体插入任务上的应用展示,自动生成的阴影和反射非常真实。]()
图9:EffectErase 在物体插入任务上的应用展示,自动生成的阴影和反射非常真实。
写在最后
EffectErase 再次证明了“任务协同”的威力。将看似对立的移除和插入任务放在一起训练,不仅没有增加负担,反而通过共享的物理常识(即物体如何影响环境)提升了各自的上限。这种“逆向思维”为视频编辑任务提供了一个非常值得借鉴的新范式。
目前,该模型仍需要用户提供初始掩码。作者也提到,未来如果能结合语音或文字指令(例如“帮我把那个跳舞的人删掉”),这种“副作用消失术”将会变得更加易用。复旦大学这次贡献的 VOR 数据集,也将成为视频物体移除领域的重要基石。
![图片]()
入群加好友(v:xiao-ma-baoli),请备注你感兴趣的技术方向


